ถอดรหัสหัวใจ AI: แนวคิด Memory → Pattern → Recall → Reconstruction
หากคุณคิดว่า AI แค่ 'จำ' ข้อมูล คุณอาจเข้าใจผิด บทความนี้เจาะลึกวงจรการประมวลผล 4 ขั้นตอนที่ทำให้ AI สมัยใหม่ฉลาดและตอบสนองได้เหมือนมนุษย์
สารบัญ
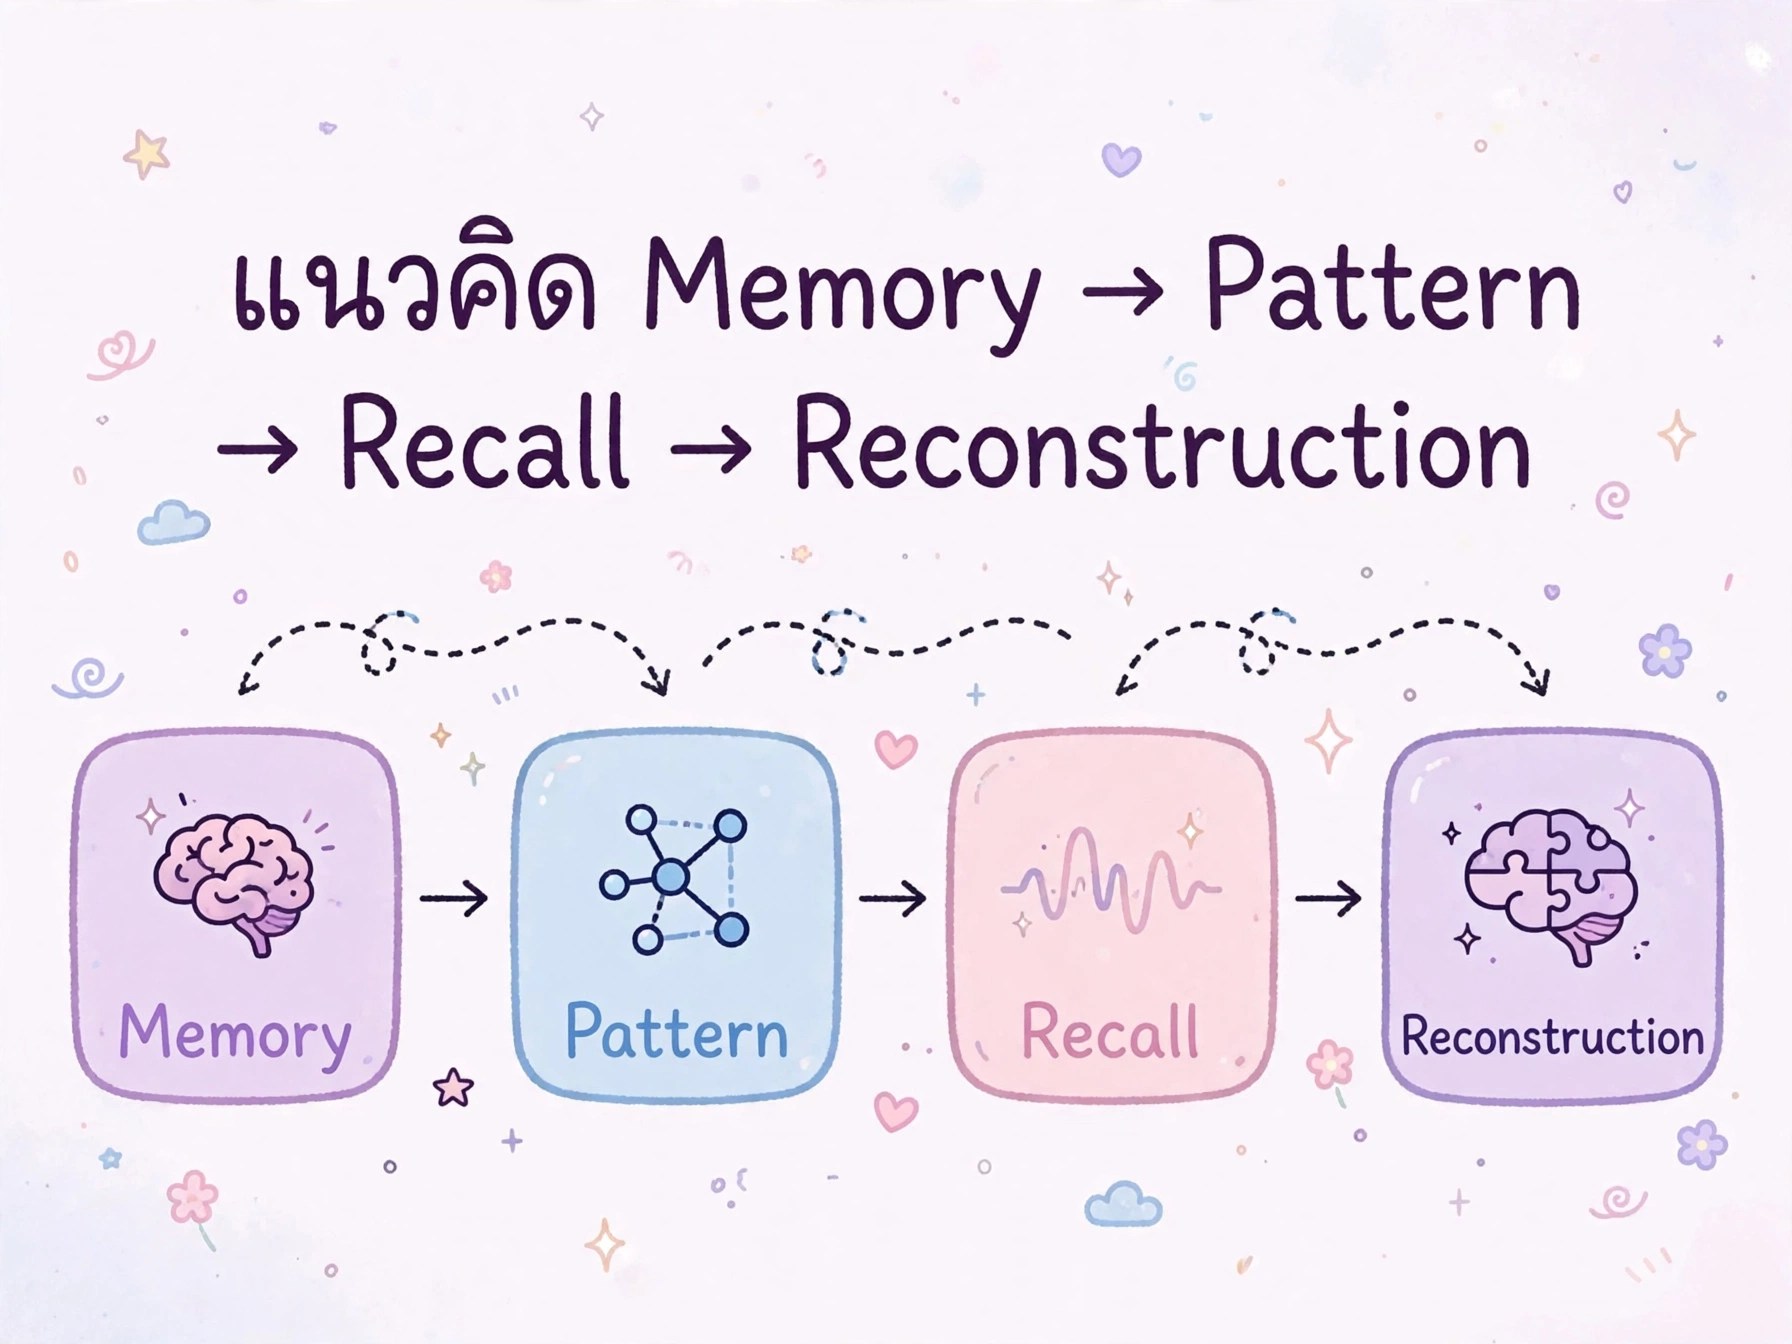
คุณเคยสงสัยไหมว่า ทำไม Large Language Model (LLM) อย่าง ChatGPT ถึงเขียนโค้ดที่ไม่เคยมีอยู่จริงใน GitHub ออกมาได้อย่างไร้ที่ติ? หรือทำไมบางครั้งมันถึงมั่นใจในข้อมูลที่ไม่จริงจนน่าตกใจ (Hallucination)? คำตอบไม่ใช่เพราะมันเป็นเวทมนตร์ แต่เป็นเพราะวงจรการประมวลผลเชิงลึกที่นักพัฒนาเรียกว่า Memory → Pattern → Recall → Reconstruction
การเข้าใจแนวคิดทั้ง 4 ขั้นตอนนี้ ไม่ใช่แค่ทฤษฎีจิตวิทยาที่ยกมาเทียบเคียง แต่มันคือแกนหลักของสถาปัตยกรรม AI สมัยใหม่ หากคุณเป็นนักพัฒนาที่กำลังทำระบบ AI Agent หรือ RAG (Retrieval-Augmented Generation) การเข้าใจวงจรนี้จะช่วยให้คุณออกแบบ Prompt และเลือกใช้เครื่องมือได้อย่างแม่นยำมากขึ้น ลดความเสี่ยงในการเกิด Hallucination และเพิ่มประสิทธิภาพของระบบได้อย่างชัดเจน
Memory: การสะสมข้อมูลในรูปแบบของ Weights และ Vectors
ในมนุษย์ Memory คือการเชื่อมต่อของเซลล์ประสาท แต่ใน AI โมเดลภาษาไม่ได้เก็บข้อมูลแบบ Database ที่มีตารางและแถวให้ค้นหาด้วย SQL คำสั่ง SELECT * FROM knowledge ไม่มีอยู่ในสมองของ AI
Memory ของ AI แบ่งออกเป็น 2 ประเภทหลักที่นักพัฒนาต้องเข้าใจ:
1. Parametric Memory (ความจำในตัวโมเดล)
เป็นการเก็บข้อมูลผ่าน Weights (น้ำหนักของโมเดล) ที่เกิดจากการฝึกฝน (Training) กับข้อมูลจำนวนมหาศาล ข้อมูลทั้งหมดถูกแปลงเป็น Vector Embeddings ซึ่งเป็นตัวเลขอาร์เรย์ที่แทนความหมายเชิงความสัมพันธ์ เมื่อ AI อ่านคำว่า "สุนัข" มันไม่ได้เก็บตัวอักษร ส-ุ-น-ั-ข แต่เก็บพิกัดทางคณิตศาสตร์ที่บอกว่า "สุนัข" อยู่ใกล้กับ "แมว" มากกว่า "รถยนต์"
2. Non-Parametric Memory (ความจำเชิงบริบท)
คือข้อมูลที่อยู่ใน Context Window ณ เวลาที่สนทนา หรือข้อมูลที่ดึงมาจากระบบ RAG ซึ่งก็คือฐานข้อมูล Vector Database ภายนอก ที่ทำหน้าที่เป็นความจำระยะสั้น (Short-term memory) หรือคลังความรู้เฉพาะทางที่โมเดลไม่เคยเรียนรู้มาก่อน
# ตัวอย่างการแปลงข้อความเป็น Vector (Non-Parametric Memory ใน RAG)
from sentence_transformers import SentenceTransformer

model = SentenceTransformer('all-MiniLM-L6-v2')
vector = model.encode("AI คืออนาคตของการพัฒนาซอฟต์แวร์")
print(f"Dimension: {len(vector)}, Vector: {vector[:5]}")
การแยกแยะระหว่างสองประเภทนี้คือหัวใจสำคัญ หากคุณต้องการให้ AI รู้เรื่อง API ล่าสุดของบริษัท คุณต้องยัดข้อมูลนั้นเข้าไปใน Non-Parametric Memory (ผ่าน Context) เพราะ Parametric Memory ของมันถูก Fix ไว้ตั้งแต่วันที่ Train โมเดลแล้ว
Pattern: การจับความสัมพันธ์ด้วย Attention Mechanism
เมื่อมีข้อมูล (Memory) เข้ามา AI จะไม่อ่านแบบเส้นตรงจากซ้ายไปขวา แต่มันจะมองหา Pattern (รูปแบบ) ผ่านกลไกที่เรียกว่า Self-Attention
Attention Mechanism ช่วยให้ AI เข้าใจบริบท เช่น คำว่า "Bank" ในประโยค "I sit on the river bank" และ "I deposit money at the bank" มีความหมายต่างกัน AI จะให้น้ำหนัก (Attention Score) กับคำรอบข้างเพื่อเข้าใจว่า "Bank" ในบริบทนี้คือ "ธนาคาร" หรือ "ริมแม่น้ำ"
ในมุมมองของนักพัฒนา การเข้าใจ Pattern หมายความว่า AI ไม่ได้ท่องจำโค้ดทั้งบล็อก แต่มันเรียนรู้ Pattern ของการเขียนโค้ด เช่น:
- การจับคู่วงเล็บเปิด-ปิด
- โครงสร้างของ Design Patterns (เช่น Singleton, Factory)
- วิธีจัดการ Error Handling ที่เหมาะสม
เมื่อคุณขอให้ AI เขียนฟังก์ชันใหม่ มันจะดึง Pattern ที่เคยเห็นมาประกอบเข้าด้วยกัน นี่คือเหตุผลที่มันสามารถเขียนโค้ดที่ไม่เคยมีอยู่ในโลกมาก่อนได้ เพราะมันเข้าใจกฎเกณฑ์ (Pattern) ไม่ใช่แค่จำข้อความ
Recall: การดึงข้อมูลขึ้นมาประมวลผล
Recall คือกระบวนการที่ AI ดึงข้อมูลจาก Memory ทั้งสองประเภทขึ้นมาใช้งาน ในบริบทของ LLM กระบวนการนี้เกิดขึ้นทุกครั้งที่มีการสร้าง Token ใหม่
การ Recall จาก Parametric Memory
เป็นการดึงความรู้ที่ฝังอยู่ใน Weights ออกมา ปัญหาหลักคือ AI อาจจะ Recall ข้อมูลที่คลาดเคลื่อนหรือล้าสมัยออกมา เพราะมันเป็นเพียงความน่าจะเป็นทางคณิตศาสตร์ ไม่ใช่การค้นหาที่แม่นยำ 100%
การ Recall จาก Non-Parametric Memory (In-Context Recall)
นี่คือจุดที่ระบบ RAG เข้ามามีบทบาท คุณสามารถบังคับให้ AI Recall ข้อมูลเฉพาะที่คุณต้องการได้ โดยการยัดข้อมูลลงใน Prompt
Context: บริษัท ABC มี API สำหรับตรวจสอบสต็อกสินค้า
Endpoint: GET /api/v2/stock/{product_id}
API Key: ต้องส่งผ่าน Header 'X-API-KEY'

Question: ช่วยเขียนโค้ด Python เพื่อเรียกดูสต็อกสินค้า P-001 ให้หน่อย
จากตัวอย่างข้างต้น AI จะทำการ Recall Pattern การเรียก HTTP Request จาก Parametric Memory และ Recall ข้อมูล Endpoint และวิธีการ Auth จาก Non-Parametric Memory ใน Context มาผสานกัน ทำให้ได้โค้ดที่ถูกต้องและเป็นปัจจุบันที่สุด
Reconstruction: การสร้างผลลัพธ์ขั้นตอนสุดท้าย
หลังจากที่ AI ดึง Memory และจับ Pattern ได้แล้ว ขั้นตอนสุดท้ายคือการ Reconstruction (การสร้างใหม่) ซึ่งในทางเทคนิคคือการทำนาย Token ถัดไป (Next-token prediction) แบบ Autoregressive
AI จะค่อยๆ สร้างคำทีละคำ โดยอ้างอิงจากข้อมูลทั้งหมดที่ Recall มาได้ กระบวนการนี้ควบคุมโดยพารามิเตอร์สำคัญ 3 ตัว ที่นักพัฒนาควรปรับแต่ง:
- Temperature: ความสุ่มในการเลือกคำ ค่าต่ำ = ความคิดสร้างสรรค์น้อย ตอบตรงประเด็น ค่าสูง = ตอบหลากหลายแต่เสี่ยงเพี้ยน
- Top-P (Nucleus Sampling): กำหนดกลุ่มคำที่มีโอกาสเกิดสูงสุดให้ AI เลือก ช่วยตัดคำที่ไม่เกี่ยวข้องออกไป
- Top-K: จำกัดจำนวนคำที่มีความน่าจะเป็นสูงสุด K อันดับแรกให้ AI เลือก
ทำไมจึงเกิด Hallucination ในขั้นตอนนี้?
Hallucination เกิดขึ้นเมื่อ AI พยายาม Reconstruction แต่ข้อมูลที่ Recall มาได้นั้นไม่เพียงพอหรือ Pattern ที่จับได้มันบกพร่อง แทนที่จะบอกว่า "ไม่รู้" มันจะใช้ความน่าจะเป็นทางสถิติสร้างคำที่ดูเหมือนจะถูกต้อง (มี Pattern ที่เข้าเท้า) แต่ขัดกับความจริง (Memory ผิด)
เช่น เมื่อถามหา API ที่ไม่มีอยู่จริง AI อาจจะสร้าง Endpoint ที่ดูสมเหตุสมผลขึ้นมา เพราะมันเข้าใจ Pattern ของ URL ว่าต้องขึ้นต้นด้วย /api/v... ตามด้วยชื่อ Resource แต่มันไม่มี Memory ที่แน่ชัดว่า Endpoint นั้นมีอยู่จริงหรือไม่
การประยุกต์ใช้แนวคิด 4 ขั้นตอนในการออกแบบระบบ AI
เมื่อเราเข้าใจวงจรนี้แล้ว นักพัฒนาสามารถนำไปปรับใช้ในการออกแบบ Prompt และสถาปัตยกรรมระบบได้ดังนี้
1. เพิ่มความแม่นยำให้ Memory ด้วย RAG
อย่าไว้ใจ Parametric Memory ในเรื่องของข้อเท็จจริงเฉพาะทาง ใช้ Vector Database เก็บข้อมูลที่อัปเดตอยู่เสมอ และดึงเข้าสู่ Context เพื่อให้ AI มี Non-Parametric Memory ที่พร้อมใช้งาน
2. กระตุ้น Pattern ที่ถูกต้องด้วย Few-Shot Prompting
หากต้องการให้ผลลัพธ์ออกมาในรูปแบบใด ยกตัวอย่างให้ AI เห็น Pattern ชัดเจน
Input: สินค้า A ราคา 100 บาท
Output: {"product": "A", "price": 100}

Input: สินค้า B ราคา 250 บาท
Output: {"product": "B", "price": 250}

Input: สินค้า C ราคา 990 บาท
Output:
การให้ตัวอย่างช่วยให้ AI จับ Pattern ของ JSON Parsing ได้อย่างรวดเร็ว ลดความเสี่ยงในการ Reconstruction ผิดฟอร์แมต
3. ควบคุมการ Recall ด้วยการแบ่งส่วนของ Prompt
จัดลำดับข้อมูลใน Prompt ให้ชัดเจน ใส่บริบทสำคัญไว้ต้น Prompt หรือท้าย Prompt (เพราะ LLM มักให้ความสนใจส่วนปลายมากกว่า) เพื่อบังคับให้ AI Recall ข้อมูลที่คุณต้องการก่อนเริ่มต้นสร้างคำตอบ
4. จำกัดการ Reconstruction ด้วย Guardrails
ตั้งค่า Temperature = 0 สำหรับงานที่ต้องการความแม่นยำทางข้อเท็จจริง เช่น การดึงข้อมูลจากฐานข้อมูล หรือการคำนวณทางคณิตศาสตร์ เพื่อให้ AI เลือกเฉพาะ Token ที่มีความน่าจะเป็นสูงสุดเท่านั้น ลดการใช้ความคิดสร้างสรรค์ในจุดที่ไม่ควร
บทสรุป
แนวคิด Memory → Pattern → Recall → Reconstruction ไม่ใช่แค่คำอธิบายเชิงทฤษฎี แต่มันคือ Blueprint สำหรับการสร้างแอปพลิเคชัน AI ที่มีประสิทธิภาพ เมื่อคุณเข้าใจว่า AI ไม่ได้คิดเหมือนมนุษย์ แต่ประมวลผลด้วยคณิตศาสตร์และความน่าจะเป็น คุณจะสามารถออกแบบระบบที่เข้ากับธรรมชาติของมันได้ดีขึ้น ลดปัญหา Hallucination และเพิ่มความน่าเชื่อถือให้กับผลลัพธ์ที่ได้
พร้อมที่จะนำแนวคิดนี้ไปปรับใช้กับโปรเจกต์ของคุณหรือยัง? ลองเริ่มต้นด้วยการทบทวน Prompt ที่คุณใช้อยู่ทุกวัน แล้วดูว่าคุณกำลังขาด Memory, Pattern, Recall หรือ Reconstruction ในขั้นตอนไหน อย่าลืมติดตามบทความต่อไปของเราเกี่ยวกับการออกแบบ RAG Architecture ขั้นสูงเพื่อยกระดับระบบ AI ของคุณให้แข็งแกร่งยิ่งขึ้น
เนื้อหาที่จัดทำโดยมี AI ช่วยจะมีป้ายกำกับ "เรียบเรียงโดยมี AI ช่วย" เพื่อให้คุณทราบอย่างชัดเจน เราถือว่าความโปร่งใสเรื่องการใช้ AI เป็นสิ่งสำคัญต่อความไว้วางใจของผู้อ่าน
ความคิดเห็น (0)
ยังไม่มีความคิดเห็น — มาเป็นคนแรกกันเถอะ!