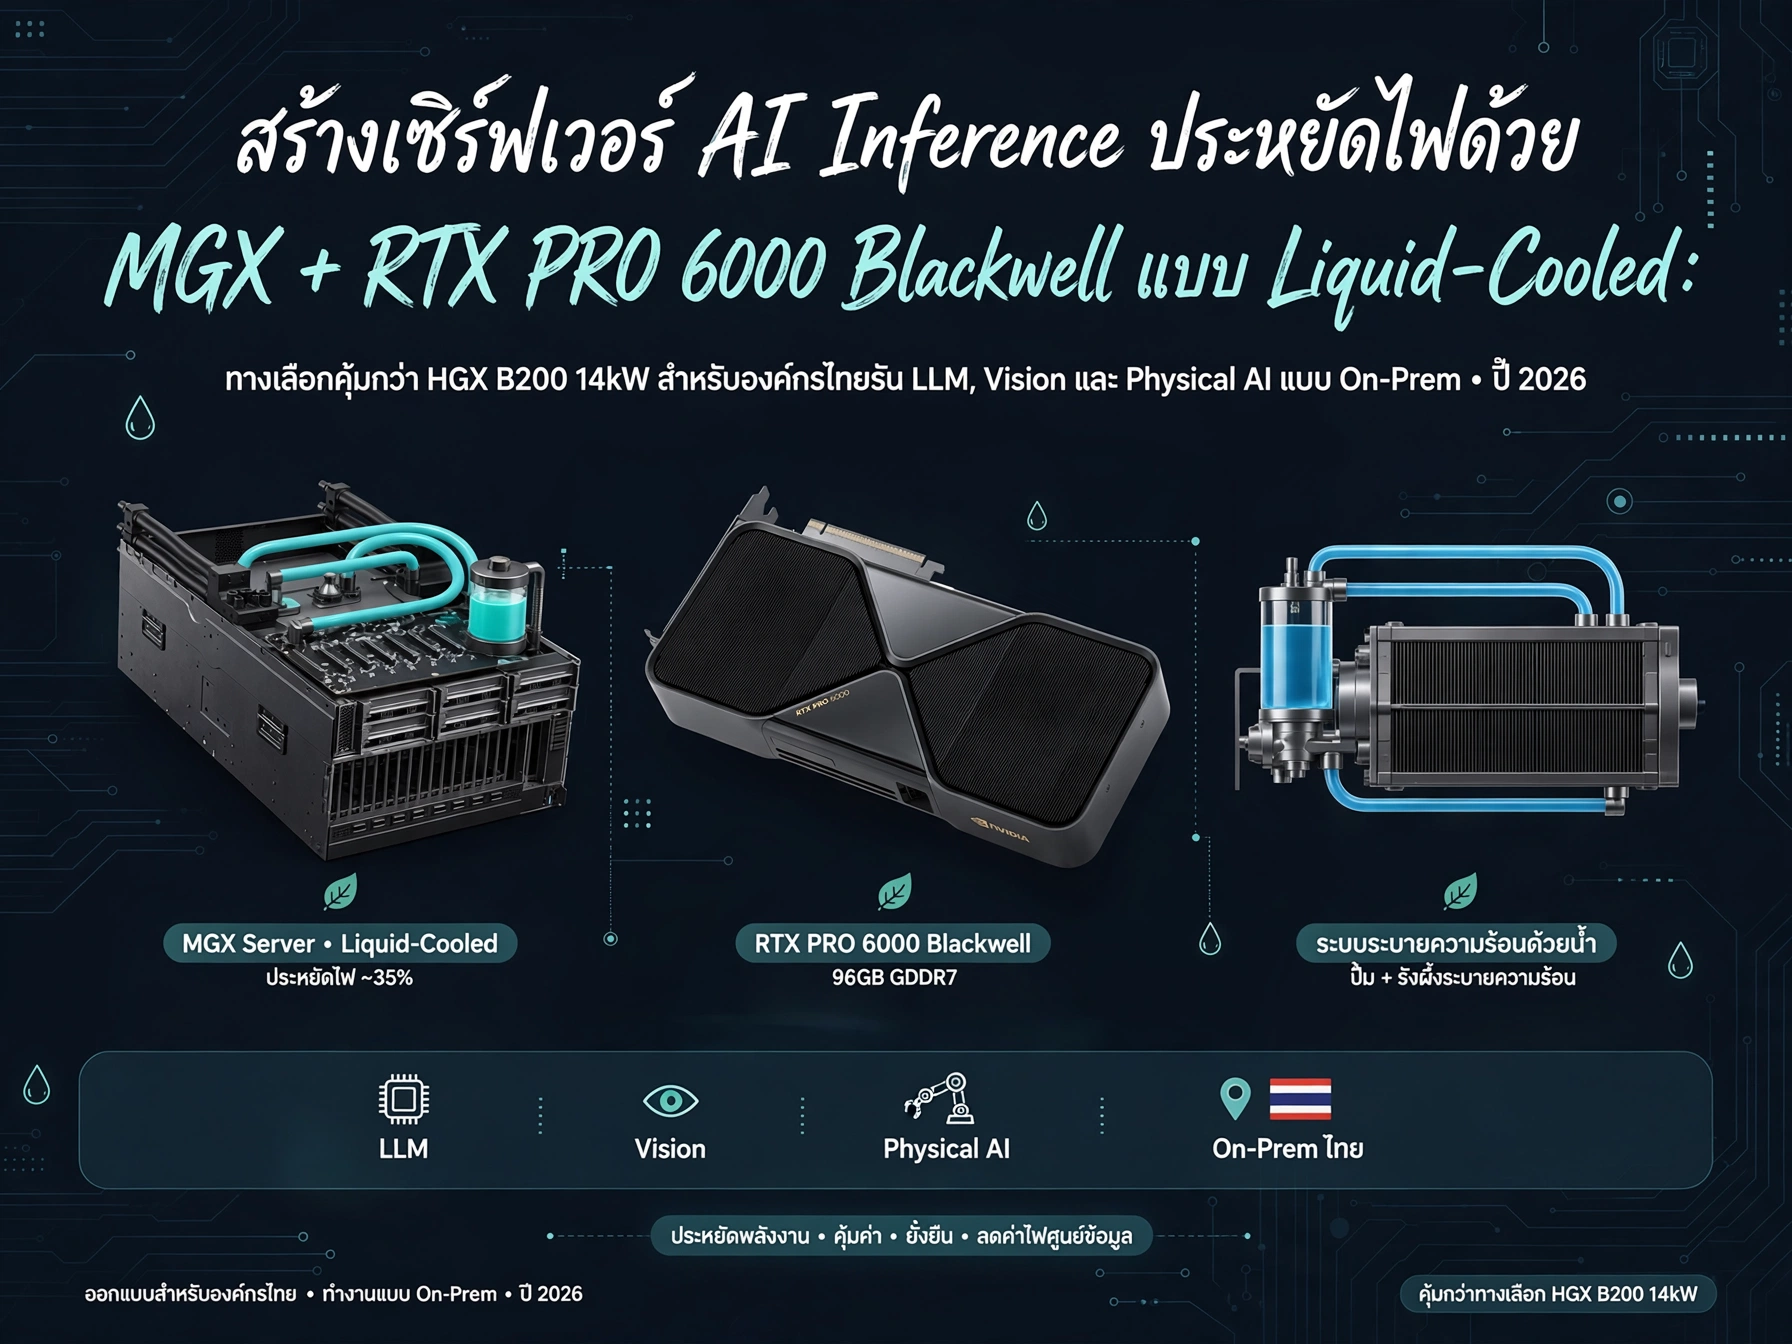
สร้างเซิร์ฟเวอร์ AI Inference ประหยัดไฟด้วย MGX + RTX PRO 6000 Blackwell แบบ Liquid-Cooled
HGX B200 แรง 14kW ต่อเบสบอร์ด แต่องค์กรไทยส่วนใหญ่แค่อยากรัน inference ไม่ได้เทรนโมเดล บทความนี้เปรียบเทียบทางเลือก MGX + RTX PRO 6000 Blackwell แบบ Liquid-Cooled ที่คุ้มกว่า ทั้งไฟ ทั้งความร้อน ทั้งงบประมาณ
สารบัญ
บิลไฟเดือนละ 3 แสนบาท เพื่อรัน LLM บน HGX B200 คุณพร้อมไหม
เซิร์ฟเวอร์ HGX B200 หนึ่งเครื่องกินไฟราว 14kW เฉพาะตัวเบสบอร์ด GPU ถ้ารัน 24/7 ที่ราคาไฟฟ้าอุตสาหกรรมไทยประมาณ 4.5 บาท/หน่วย ก็เท่ากับค่าไฟราว 45,000 บาทต่อเดือน เฉพาะ GPU อย่างเดียว ยังไม่นับ CPU, แรม, พัดลม, และระบบทำความเย็นห้องที่ต้องรองรับปริมาณความร้อนขนาดนั้น
คำถามคือ องค์กรไทยส่วนใหญ่ที่อยากรัน LLM, Vision Model หรือ Physical AI แบบ on-prem จำเป็นต้องลงทุนขนาดนั้นไหม ความจริงคือ ถ้าภารกิจหลักคือ inference ไม่ใช่ training โมเดลขนาดหลายร้อยพันล้านพารามิเตอร์ตั้งแต่ต้น ก็มีทางเลือกอื่นที่คุ้มกว่ามาก
HGX B200 แรงจริง แต่ Overkill สำหรับ Inference
HGX B200 ออกแบบมาเพื่องานหนักระดับ hyperscaler โดยเฉพาะ จุดเด่นคือ
- 4× B200 GPU แต่ละตัวมี HBM3e 192GB รวม 768GB ต่อเบสบอร์ด
- NVLink 5 แบนด์วิดท์ 1.8 TB/s ต่อคู่ เชื่อม GPU ทุกตัวเป็นหนึ่งเดียว
- FP4 performance สูงถึง 18 PFLOPS ต่อ GPU
แต่จุดอ่อนสำหรับบริบทไทยคือ
- กินไฟ 14kW+ ต่อเบสบอร์ด ต้องการห้อง DC มาตรฐานสูง
- ราคาต่อยูนิตสูงมาก ออร์เดอร์ต้องรอคิวยาว
- ระบบทำความเย็นต้องลงทุนหนัก ในเมืองไทยที่อุณหภูมิ ambient เฉลี่ย 32-35°C การดึงความร้อน 14kW ออกจากห้องไม่ใช่เรื่องเล็ก
- ส่วนใหญ่ใช้ประสิทธิภาพได้ไม่เต็มที่ เพราะ inference ไม่ต้องการ NVLink แบนด์วิดท์ระดับนั้น
MGX: สถาปัตยกรรมโมดูลาร์ที่ยืดหยุ่นกว่า
NVIDIA MGX เป็นสเปคเซิร์ฟเวอร์แบบโมดูลาร์ ออกแบบให้ผู้ผลิต OEM/ODM สามารถประกอบเซิร์ฟเวอร์ที่รองรับ GPU หลายประเภทบนชาสซีตัวเดียวกันได้ ไม่จำกัดแค่ HGX แต่รองรับตั้งแต่ Grace-Hopper, Grace-Blackwell ไปจนถึง PCIe GPU อย่าง RTX PRO 6000 Blackwell
จุดเด่นของ MGX สำหรับองค์กรไทย
- เลือก GPU ตามงานจริง ไม่ต้องจ่ายเผื่อสเปคที่ไม่ได้ใช้
- พลังงานต่อยูนิตต่ำกว่า ขึ้นอยู่กับการเลือก GPU
- รองรับ liquid cooling ได้ตั้งแต่ต้นทาง ลดภาระระบบปรับอากาศห้อง
- ขยายได้ภายหลัง เปลี่ยน GPU รุ่นใหม่โดยใช้ชาสซีเดิม
RTX PRO 6000 Blackwell: GPU สำหรับ Inference ที่คุ้มที่สุดในตลาด
RTX PRO 6000 Blackwell ใช้ชิป GB202 ตัวเดียวกับที่อยู่ใน GeForce RTX 5090 แต่ปรับสเปคเป็นโปรดักต์ระดับ workstation/datacenter จุดสำคัญคือ
| สเปค | RTX PRO 6000 Blackwell | B200 (ใน HGX) |
|---|---|---|
| หน่วยความจำ | 96GB GDDR7 | 192GB HBM3e |
| แบนด์วิดท์หน่วยความจำ | ~1,800 GB/s | ~8,000 GB/s |
| TDP | ~600W | ~1,000W |
| อินเตอร์คอนเนกต์ | PCIe Gen5 (ไม่มี NVLink) | NVLink 5 |
| FP4 Performance | ~3,400 TFLOPS | ~4,500 TFLOPS |
| ราคาประมาณ | กลาง | สูงมาก |
ดูแล้ว B200 เหนือกว่าเกือบทุกด้าน แต่ถ้าเราเปลี่ยนมุมมองเป็น performance per watt และ performance per baht สำหรับงาน inference ภาพจะต่างออกไป
ทำไม GDDR7 ก็เพียงพอสำหรับ Inference
งาน inference โดยเฉพาะ LLM serving มี bottleneck หลักที่ memory bandwidth จริง แต่ไม่ได้ต้องการแบนด์วิดท์ระดับ 8,000 GB/s เสมอไป โมเดลขนาด 70B ที่ quantize เป็น FP8 ใช้หน่วยความจำราว 70GB รันบน RTX PRO 6000 Blackwell 96GB ได้สบาย และ GDDR7 ที่ 1,800 GB/s ให้ throughput ที่เพียงพอสำหรับ batch size ที่เหมาะสม
สำหรับโมเดลที่ใหญ่กว่านั้น เช่น Llama 3 405B สามารถใช้ tensor parallelism ข้าม 2-4 ตัว RTX PRO 6000 บน MGX ได้ แม้จะไม่มี NVLink แต่ PCIe Gen5 x16 ให้แบนด์วิดท์ 128 GB/s ต่อทิศทาง ซึ่งเพียงพอสำหรับ inference ที่ไม่ใช่งาน training ขนาดใหญ่
Liquid Cooling: ไม่ใช่ลักซ์ชัวรี แต่ความจำเป็นในเมืองไทย
ปัญหาใหญ่ของการรัน GPU ในประเทศเขตร้อนชื้นคือ อุณหภูมิ ambient สูงทำให้ระบบทำความเย็นแบบอากาศทำงานหนัก พัดลมดันเร็วขึ้น กินไฟมากขึ้น และอายุการใช้งานสั้นลง
Liquid cooling แบบ direct-to-chip (D2C) บนแพลตฟอร์ม MGX ช่วยแก้ปัญหานี้ตรงๆ
- ดึงความร้อนได้มากกว่าอากาศ 3-5 เท่า ที่พื้นที่ผิวเท่ากัน
- อุณหภูมิ GPU ต่ำกว่า ลด thermal throttling โดยเฉพาะตอนรันโหลดต่อเนื่อง
- ลดโหลด CRAC ระบบปรับอากาศห้อง DC ไม่ต้องทำงานหนัก ประหยัดไฟได้ 20-30% ของส่วน cooling
- เงียบกว่า สำคัญถ้าเซิร์ฟเวอร์อยู่ในสำนักงานไม่ใช่ DC เต็มรูปแบบ
RTX PRO 6000 Blackwell มีเวอร์ชัน liquid-cooled โดยตรงจาก NVIDIA และพันธมิตร ทำให้ติดตั้งบน MGX ที่ออกแบบรองรับ liquid cooling ได้ตั้งแต่ต้น
กรณีศึกษา: 3 โหลดงานที่เหมาะกับ MGX + RTX PRO 6000
1. LLM Serving (เช่น Llama 3.1 70B, Qwen 2.5 72B)
โมเดล 70B ที่ FP8 ใช้หน่วยความจำราว 70GB รันบน RTX PRO 6000 Blackwell 96GB ได้ในเครื่องเดียว เหลือพื้นที่สำหรับ KV cache และ batching
เปรียบเทียบกับการรันบน HGX B200 ที่มี 192GB ต่อ GPU คุณจะใช้หน่วยความจำได้ไม่เกิน 40% ของที่มี ส่วนที่เหลือนั่งว่าง แต่คุณยังจ่ายไฟ 1,000W ต่อ GPU อยู่ดี
สำหรับ throughput ที่ระดับ 50-200 concurrent requests ต่อเครื่อง MGX กับ RTX PRO 6000 ตั้งแต่ 1-2 ตัว ก็เพียงพอสำหรับองค์กรขนาดกลาง
2. Vision Model (เช่น SAM 2, Florence-2, YOLO-World)
โมเดล Vision ส่วนใหญ่มีขนาดเล็กกว่า LLM มาก แต่ต้องการ latency ต่ำและ throughput สูง กรณีนี้ RTX PRO 6000 Blackwell ที่มี FP4 performance สูงและราคาต่อ TFLOPS ต่ำกว่า B200 อย่างชัดเจน คือทางเลือกที่เหมาะสมกว่า
ตัวอย่างการใช้งานจริง ระบบตรวจจับข้อบกพร่องบนสายการผลิต ที่ต้องประมวลผลภาพ 30 fps ต่อกล้อง จาก 20 กล้องพร้อมกัน หนึ่งเครื่อง MGX กับ RTX PRO 6000 สองตัว รองรับได้สบาย
3. Physical AI / Robotics Simulation
Physical AI คือแนวโน้มที่กำลังมาแรงในปี 2026 ครอบคลุมทั้งการจำลองสภาพแวดล้อมสำหรับหุ่นยนต์, digital twin ของโรงงาน, และ reinforcement learning สำหรับระบบอัตโนมัติ
งานประเภทนี้ใช้ทั้ง GPU สำหรับ rendering และ physics simulation จึงต้องการ VRAM ขนาดใหญ่และ FP32/FP16 performance ที่ดี RTX PRO 6000 Blackwell ที่มี 96GB GDDR7 และ CUDA cores จำนวนมาก เหมาะกับงานนี้มาก โดยเฉพาะเมื่อรันคู่กับ Isaac Sim หรือ MuJoCo XLA
คำนวณ TCO สั้นๆ: 1 ปี
| รายการ | HGX B200 (1 เครื่อง) | MGX + 2× RTX PRO 6000 LC |
|---|---|---|
| กำลังไฟ GPU | ~14kW | ~1.2kW |
| ค่าไฟ GPU/เดือน | ~45,000 บาท | ~3,900 บาท |
| ค่าไฟ cooling ประมาณ | ~18,000 บาท | ~1,500 บาท |
| ค่าไฟรวม/เดือน | ~63,000 บาท | ~5,400 บาท |
| ค่าไฟรวม/ปี | ~756,000 บาท | ~64,800 บาท |
ต่างกันราว 690,000 บาทต่อปี เฉพาะค่าไฟ ถ้าดูในระยะ 3 ปี ก็เกิน 2 ล้านบาท ซึ่งเป็นเงินที่สามารถซื้อเครื่อง MGX เพิ่มได้อีกหลายเครื่อง
ข้อจำกัดที่ต้องรู้ก่อนตัดสินใจ
MGX + RTX PRO 6000 ไม่ใช่คำตอบสำหรับทุกกรณี มีข้อจำกัดที่ต้องรับรู้
- ไม่มี NVLink ทำให้ tensor parallelism ข้าม GPU มี overhead สูงกว่า ไม่เหมาะกับ training โมเดลขนาดใหญ่
- GDDR7 ช้ากว่า HBM3e หากงานเป็น memory-bound อย่างรุนแรง เช่น long-context LLM ที่ context หลายหมื่น token อาจเห็นผลต่าง latency ชัดเจน
- ไม่ได้รองรับ FP4 แบบเต็มรูปแบบเท่า B200 แม้จะมี FP4 support แต่ throughput ต่อตัวยังไม่เทียบ B200 ได้
- ต้องลงทุนระบบ liquid cooling infrastructure ถ้ายังไม่มี ต้นทุนเริ่มต้นอาจสูง แต่จะคุ้มในระยะยาว
สรุป: เลือกตามงาน ไม่ใช่เลือกตามสเปคสูงสุด
ถ้าองค์กรของคุณมีภารกิจหลักคือ training foundation model ขนาดใหญ่ HGX B200 ยังเป็นทางเลือกที่เหมาะสม แต่ถ้าเป้าหมายคือ serving LLM, Vision model และ Physical AI แบบ on-prem ในปริมาณที่องค์กรขนาดกลางถึงใหญ่ใช้จริง MGX + RTX PRO 6000 Blackwell แบบ liquid-cooled คือจุดที่คุ้มค่าที่สุดในตลาดปี 2026
ประหยัดไฟ 6 เท่า ประหยัดความร้อน ลดความซับซ้อนของโครงสร้างพื้นฐาน และยังขยายได้ภายหลัง สำหรับองค์กรไทยที่ค่าไฟและอากาศร้อนเป็นตัวแปรสำคัญ นี่คือทางเลือกที่สมเหตุสมผลกว่า
ลองประเมินโหลดงานของทีมคุณดู ว่าส่วนใหญ่เป็น inference หรือ training ถ้าคำตอบคือ inference ก็ถึงเวลาพิจารณา MGX + RTX PRO 6000 Blackwell แล้ว แชร์บทความนี้ให้ทีม infra ดู หรือมาคุยกันต่อในคอมเมนต์ว่าองค์กรของคุณกำลังเผชิญปัญหาไฟ/ความร้อนอย่างไร
เนื้อหาที่จัดทำโดยมี AI ช่วยจะมีป้ายกำกับ "เรียบเรียงโดยมี AI ช่วย" เพื่อให้คุณทราบอย่างชัดเจน เราถือว่าความโปร่งใสเรื่องการใช้ AI เป็นสิ่งสำคัญต่อความไว้วางใจของผู้อ่าน
ความคิดเห็น (0)
ยังไม่มีความคิดเห็น — มาเป็นคนแรกกันเถอะ!