เลือกเซิร์ฟเวอร์ AI ออฟไลน์แบบไหนดีสำหรับ SME ไทย? เทียบ NPU, RTX 5090 และ DGX Spark
ปี 2026 กฎ PDPA เข้มข้นขึ้น ส่งข้อมูลลูกค้าขึ้น Cloud AI ไม่ได้แล้ว? ลองมาดูวิธีรัน Ollama ออฟไลน์ 100% และเลือกฮาร์ดแวร์ที่คุ้มค่าที่สุดสำหรับ SME ไทย
สารบัญ
 ลองนึกภาพดูครับ คุณมีไฟล์ข้อมูลส่วนบุคคลของลูกค้าเป็นร้อยเรื่อง แล้วอยากให้ AI ช่วยสรุปและจัดหมวดหมู่ แต่กฎหมาย PDPA ในปี 2026 บอกว่าห้ามส่งข้อมูลส่วนบุคคลขึ้น Cloud ของต่างประเทศเด็ดขาด คุณจะทำยังไง?
การใช้ ChatGPT หรือ Claude แบบเดิมอาจไม่ใช่ทางออกที่ปลอดภัยอีกต่อไป โดยเฉพาะธุรกิจ SME ในไทยที่ต้องระวังเรื่องการรั่วไหลของข้อมูลเป็นพิเศษ ทางออกที่กำลังเป็นที่นิยมและเข้าถึงได้ง่ายที่สุดในตอนนี้ คือการสร้าง "เซิร์ฟเวอร์ AI ออฟไลน์" ของตัวเองด้วย Ollama
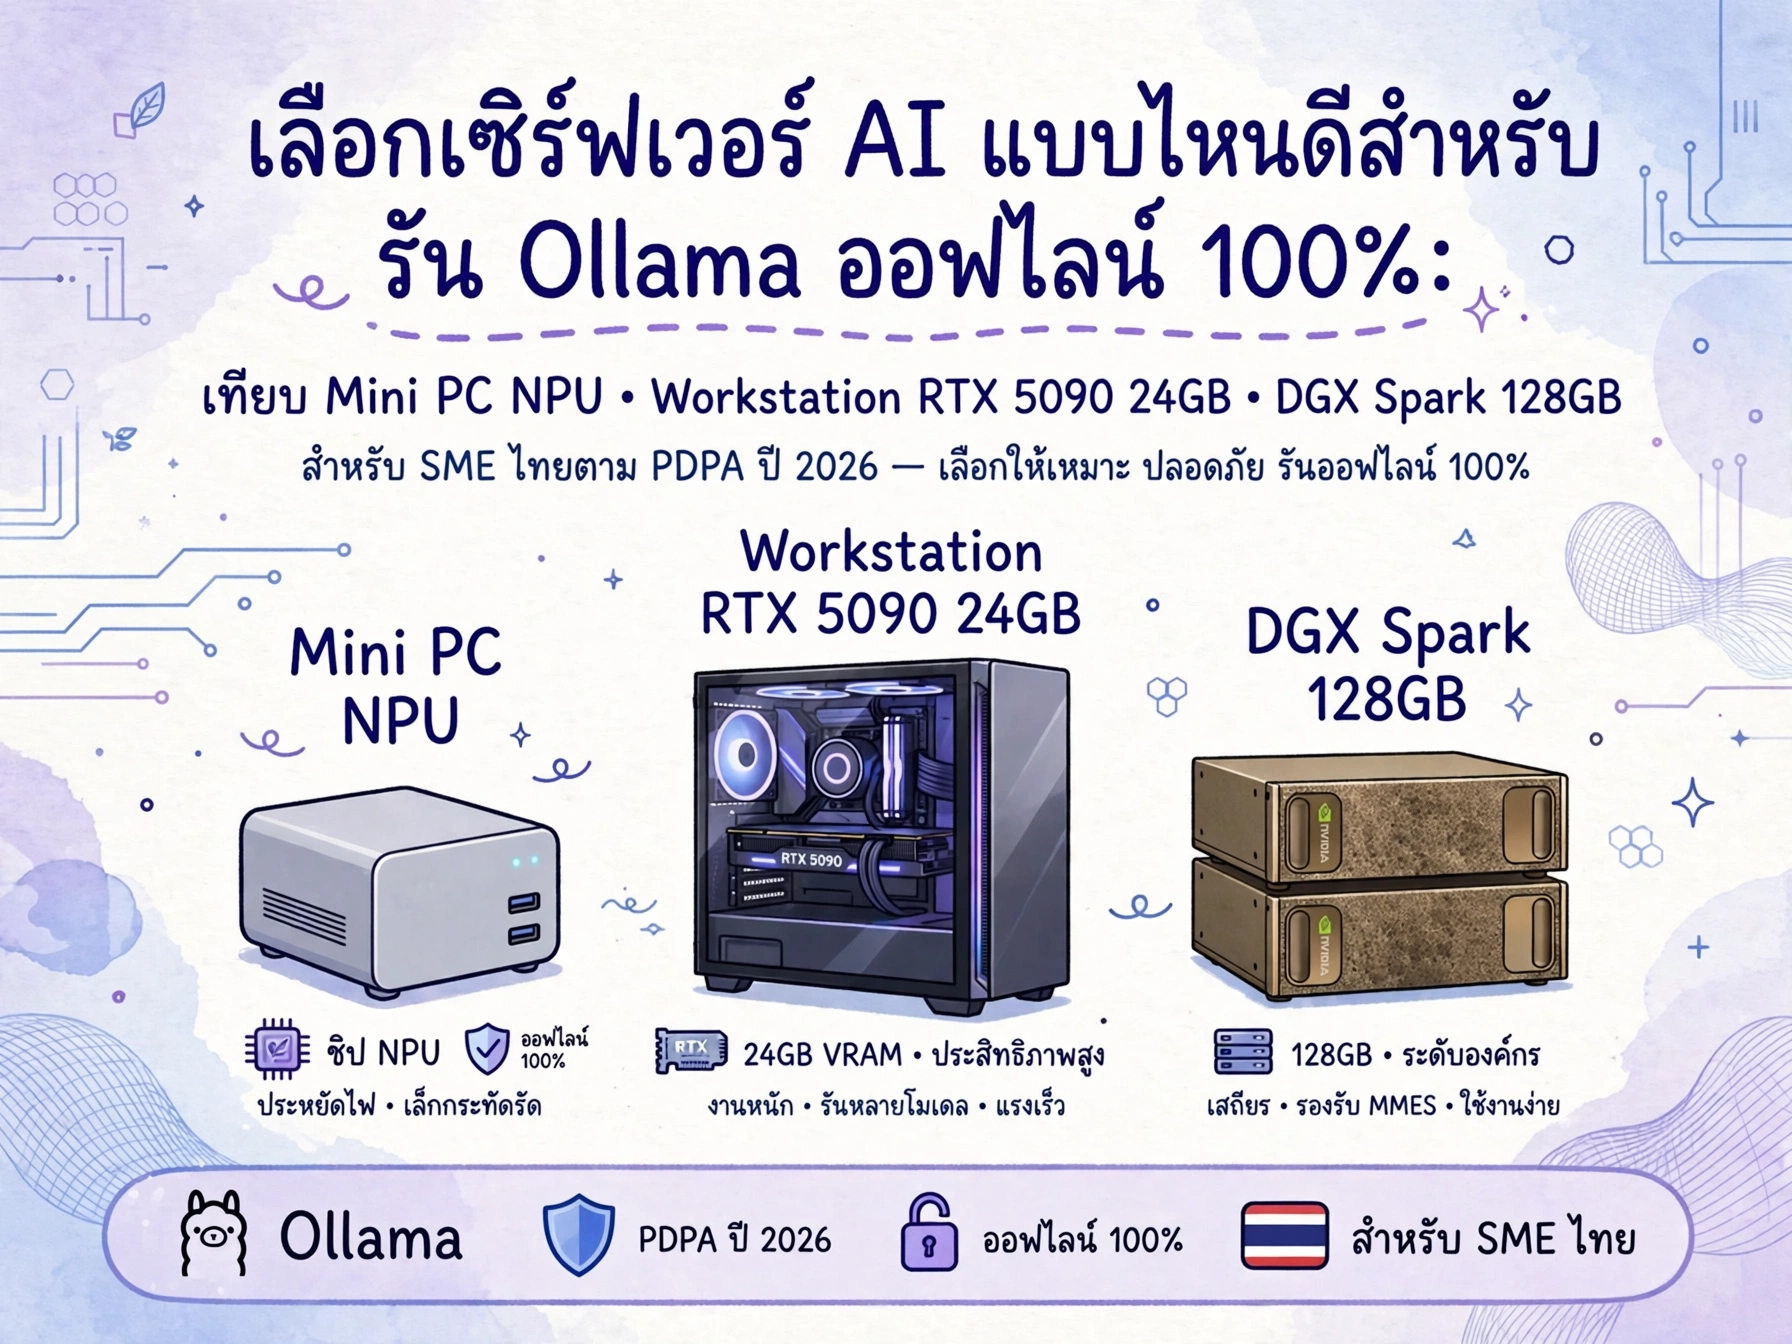
วันนี้เราจะมาเจาะลึกกันว่า ถ้า SME ไทยอยากรัน Ollama แบบออฟไลน์ 100% ควรเลือกฮาร์ดแวร์ระดับไหน ระหว่าง Mini PC NPU, Workstation การ์ดจอ RTX 5090 24GB และเครื่องระดับองค์กรอย่าง DGX Spark 128GB แบบไหนจะคุ้มค่าที่สุด
ทำไม Ollama ถึงเป็นพระเอกของยุค PDPA?
Ollama เป็นเครื่องมือโอเพนซอร์สที่ช่วยให้เรารัน Large Language Model (LLM) บนเครื่องของเราเองได้ง่ายๆ เหมือนการดึง Docker image มารัน ข้อดีคือไม่มีข้อมูลส่งออกอินเทอร์เน็ตแม้แต่บิตเดียว คุณเป็นเจ้าของข้อมูล 100% ซึ่งตอบโจทย์กฎหมาย PDPA ได้ตรงตัว
แต่การรัน AI ในเครื่องเครื่องเดียว สิ่งที่สำคัญที่สุดคือ "หน่วยความจำ" ไม่ใช่แค่ความเร็วประมวลผล เพราะยิ่งโมเดลใหญ่ ยิ่งต้องการแรมจำนวนมากเพื่อไม่ให้ระบบไปดึงพื้นที่จาก SSD มาทดแทน (ซึ่งจะทำให้ช้ามาก) มาดู 3 ตัวเลือกยอดนิยมกันครับ
ตัวเลือกที่ 1: Mini PC NPU (ราคาประหยัด เริ่มต้นจ๊าบ)
ตัวเลือกแรกเหมาะสำหรับธุรกิจที่งบประมาณจำกัด หรือต้องการเครื่องขนาดเล็กตั้งไว้หน้าเคาน์เตอร์ร้านค้า เครื่องประเภทนี้มักจะใช้ CPU รุ่นใหม่ๆ ที่มี NPU (Neural Processing Unit) ในตัว เช่น Intel Core Ultra หรือ AMD Ryzen AI 9
จุดเด่น
- ราคาถูก: ลงทุนแค่ประมาณ 20,000 - 35,000 บาท
- ประหยัดไฟ: กินพลังงานน้อยมาก ไม่ต้องห่วงเรื่องค่าไฟเพิ่ม
- ขนาดกะทัดรัด: วางบนโต๊ะได้ ไม่ต้องทำห้องเซิร์ฟเวอร์
ข้อจำกัด
- รันได้แค่โมเดลเล็กๆ อย่าง Llama 3.1 8B หรือ Qwen 2.5 7B แบบ Quantization (บีบอัดขนาด)
- ความเร็วในการตอบสนอง (Token/s) จะอยู่ที่ประมาณ 10-20 คำต่อวินาที พอใช้งานได้แต่ไม่ไวมาก
เหมาะสำหรับ: ร้านค้าที่ต้องการ AI ช่วยตอบคำถามพื้นฐานจากคู่มือสินค้า, ธุรกิจที่มีพนักงาน 1-2 คนใช้งานพร้อมกัน
ตัวเลือกที่ 2: Workstation RTX 5090 24GB (จุดศูนย์กลางความคุ้มค่า)
ถ้าให้เลือกว่าตัวเลือกไหนคือ "สวีทสปอต" สำหรับ SME ไทย ผมขอยกให้เวิร์กสเตชันที่ลงการ์ดจอ RTX 5090 24GB ครับ ในปี 2026 การ์ดจอระดับนี้ถือเป็นมาตรฐานใหม่สำหรับนักพัฒนาและธุรกิจขนาดกลาง
จุดเด่น
- VRAM 24GB: สามารถรันโมเดลระดับ 14B ถึง 32B (แบบ Q4) ได้อย่างลื่นไหล โมเดลขนาดนี้ฉลาดพอที่จะทำงานเอกสารซับซ้อนได้
- ความเร็วสูง: ให้ความเร็วตอบสนองที่ 50-80 Token/s ทำให้การแชทกับ AI รู้สึกเหมือนคุยกับคนจริง
- รองรับผู้ใช้หลายคน: ตั้งเป็น API Server ให้ทีมงาน 5-10 คนเรียกใช้พร้อมกันได้สบายๆ
สเปกแนะนำ
- CPU: AMD Ryzen 9 หรือ Intel Core i9 รุ่นล่าสุด
- RAM: 64GB DDR5 (เผื่อทำ RAG กับเอกสารจำนวนมาก)
- Storage: NVMe SSD 2TB ขึ้นไป
- งบประมาณโดยประมาณ: 150,000 - 200,000 บาท
เหมาะสำหรับ: บริษัทที่ต้องการ AI ช่วยเขียนโค้ด, สรุปสัญญา, หรือทำระบบ Customer Service ภายในที่ต้องการความเร็วและความแม่นยำระดับสูง
ตัวเลือกที่ 3: DGX Spark 128GB (บิ๊กบอสสำหรับองค์กร)
ถ้าธุรกิจของคุณเป็นบริษัทขนาดใหญ่ขึ้น มีพนักงาน 50-100 คนที่ต้องใช้ AI พร้อมกัน หรือต้องรันโมเดลระดับ 70B ขึ้นไปเพื่อความแม่นยำสูงสุดในงานกฎหมายและการแพทย์ เครื่องระดับ DGX Spark 128GB คือคำตอบ
เครื่องประเภทนี้อาจจะมาในรูปแบบ Multi-GPU หรือสถาปัตยกรรมหน่วยความจำรวมขนาดใหญ่ (Unified Memory) ที่ให้แบนด์วิดท์สูงมาก
จุดเด่น
- พลังประมวลผลมหาศาล: รันโมเดลอย่าง Llama 3.1 70B ได้แบบไม่บีบอัดขนาดมากนัก ความฉลาดเทียบเท่า GPT-4 รุ่นก่อนๆ
- รองรับ Concurrent Users สูง: ให้บริการทั้งบริษัทได้โดยไม่มีอาการคอขวด
- ความเสถียรระดับ Enterprise: ออกแบบมาให้รัน 24/7 มีระบบระบายความร้อนและไฟเลี้ยงสำรองที่แข็งแกร่ง
ข้อจำกัด
- ราคาสูง: อาจเริ่มต้นที่หลักล้านบาทจนถึงหลักสิบล้านบาท
- ต้องการพื้นที่และการดูแล: อาจต้องมีห้องเซิร์ฟเวอร์และแอดมินดูแลเฉพาะ
เหมาะสำหรับ: โรงพยาบาลเอกชน, บริษัทเงินทุน, หรือสำนักงานกฎหมายที่ข้อมูลมีความอ่อนไหวสูงและต้องการประสิทธิภาพสูงสุด
สรุป: SME ไทยควรเลือกแบบไหน?
การเลือกเซิร์ฟเวอร์ AI ออฟไลน์ไม่ใช่เรื่องของ "อันไหนแรงที่สุด" แต่เป็นเรื่องของ "อันไหนตอบโจทย์งานและงบเราที่สุด"
- ถ้าคุณเพิ่งเริ่มต้น อยากลองใช้ AI ในองค์กรแบบปลอดภัย ให้เริ่มจาก Mini PC NPU เพราะลงทุนน้อยแต่ได้สัมผัสประสบการณ์จริง
- ถ้าคุณมีทีมพัฒนาหรือทีมการตลาดที่ต้องใช้ AI ในงานประจำวันจริงๆ จังๆ Workstation RTX 5090 24GB คือทางออกที่คุ้มค่าที่สุดในระยะยาว
- แต่ถ้าคุณเป็นองค์กรขนาดใหญ่ที่ AI คือหัวใจสำคัญของธุรกิจ การลงทุนกับ DGX Spark 128GB จะช่วยลดความเสี่ยงด้านความปลอดภัยข้อมูลและเพิ่มศักยภาพการแข่งขันได้อย่างชัดเจน
การรัน Ollama ออฟไลน์ไม่ใช่เรื่องยากอย่างที่คิด แค่คุณเลือกฮาร์ดแวร์ให้เข้ากับสเปกงาน ลองเริ่มต้นติดตั้ง Ollama บนเครื่องที่มีอยู่ก่อนได้ แล้วค่อยๆ ขยายขนาดตามความต้องการของทีมครับ
คุณคิดว่าธุรกิจของคุณเหมาะกับระดับไหน? มาแชร์สเปกเครื่องที่คุณใช้รัน AI ออฟไลน์กันได้ในคอมเมนต์เลย หรือถ้าใครมีคำถามเรื่องการตั้งค่า Ollama ให้รองรับ PDPA สามารถโพสต์ถามในคอมมูนิตี้ได้เลยครับ เรามีนักพัฒนาพร้อมช่วยตอบทุกข้อสงสัย!
เนื้อหาที่จัดทำโดยมี AI ช่วยจะมีป้ายกำกับ "เรียบเรียงโดยมี AI ช่วย" เพื่อให้คุณทราบอย่างชัดเจน เราถือว่าความโปร่งใสเรื่องการใช้ AI เป็นสิ่งสำคัญต่อความไว้วางใจของผู้อ่าน
ความคิดเห็น (0)
ยังไม่มีความคิดเห็น — มาเป็นคนแรกกันเถอะ!