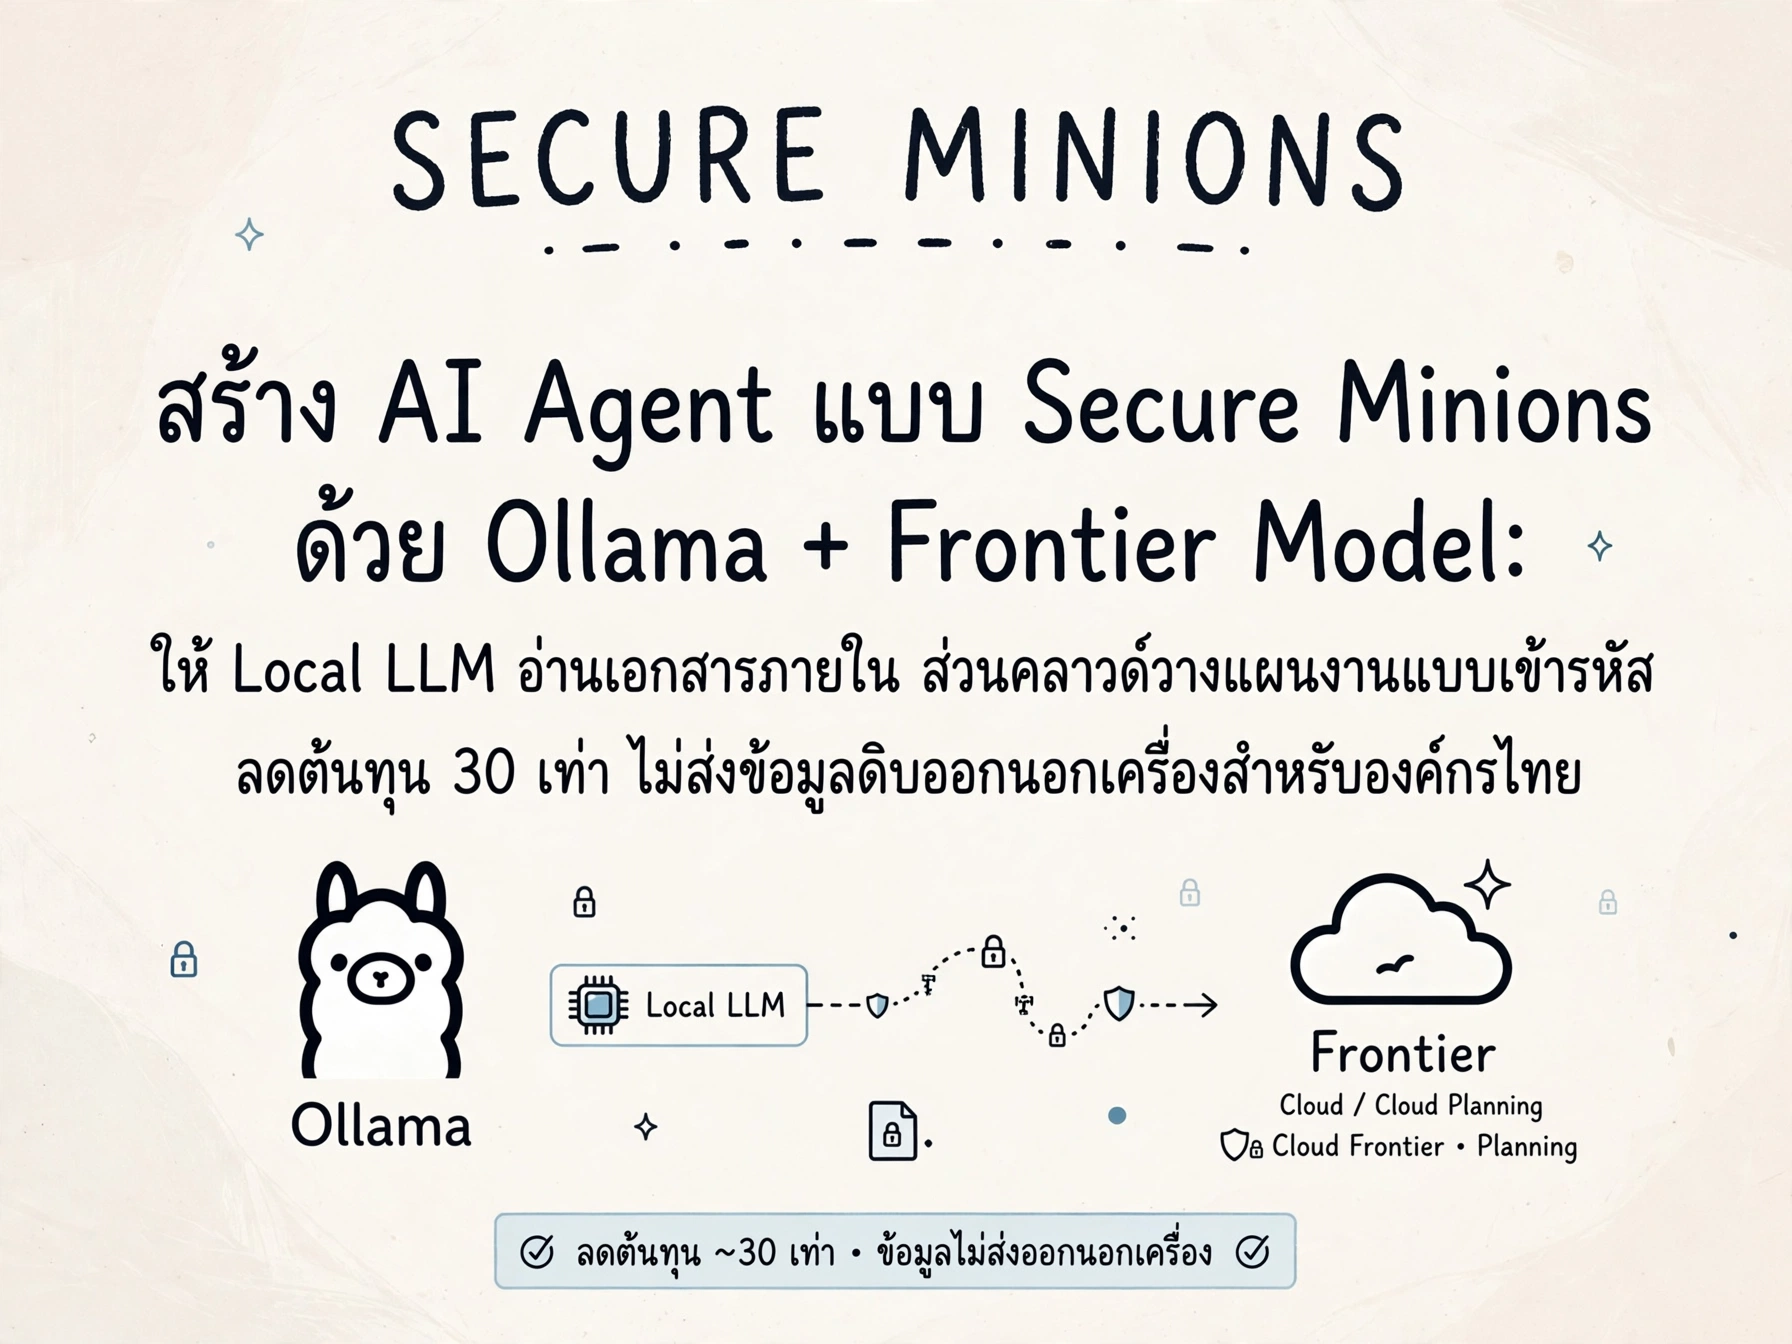
สร้าง AI Agent แบบ Secure Minions ด้วย Ollama + Frontier Model: เก็บข้อมูลดิบไว้ในเครื่อง ลดต้นทุน 30 เท่า
เทคนิคการแบ่งงาน AI Agent ให้ Local LLM จัดการข้อมูลอ่อนไหว ส่วน Cloud วางแผนเชิงตรรกะ ปลอดภัยและประหยัดสำหรับองค์กรไทย
สารบัญ
ทำไมองค์กรไทยถึงกลัว AI แต่ก็อยากใช้
ลองนึกภาพนี้: คุณมีเอกสารสัญญาลูกค้า 10,000 หน้า อยากให้ AI สรุปและต问งแผนการติดตามผล แต่ส่งขึ้น Cloud ไม่ได้เพราะเป็นข้อมูลห้ามรั่ว ในขณะเดียวกัน LLM ที่รันในเครื่องอย่าง Llama 3 ก็ยังไม่ฉลาดพอที่จะวางแผนซับซ้อนได้เท่า GPT-4o หรือ Claude
นี่คือจุดที่รูปแบบ Secure Minions เข้ามาแก้ปัญหา
Secure Minions คืออะไร
แนวคิดง่ายๆ คือการแบ่งหน้าที่ AI Agent ออกเป็นสองชั้น:
- Local Minion (Ollama): ทำหน้าที่ "คนงาน" อ่านเอกสารดิบ สกัดข้อมูล สรุป แปล และจัดการข้อมูลอ่อนไหวทั้งหมด โดยไม่ส่งอะไรออกนอกเครื่อง
- Frontier Overseer (Cloud Model): ทำหน้าที่ "ผู้จัดการ" รับเฉพาะข้อมูลที่ผ่านการสกัดและไม่ระบุตัวตนแล้ว นำมาวางแผน ตัดสินใจ และสร้างลำดับงาน
เปรียบเหมือนให้พนักงานระดับปฏิบัติการอ่านเอกสารลับในห้องนิรภัย แล้วส่งเฉพาะสรุปผลไปให้ผู้บริหารวางกลยุทธ์
สถาปัตยกรรมเบื้องต้น
ระบบนี้ใช้โครงสร้างแบบ Pipeline ตามลำดับ:
- ผู้ใช้ส่งคำสั่งเข้าระบบ
- Frontier Model วิเคราะห์คำสั่งและสร้าง Task Plan (เช่น "อ่านสัญญา → สกัดมูลค่า → จัดหมวด → สรุป")
- Local LLM รับ Task Plan และทำงานกับเอกสารจริงในเครื่อง
- Local ส่งผลลัพธ์ที่ผ่านการล้างข้อมูลอ่อนไหวกลับไปให้ Frontier
- Frontier รวมผลและตอบผู้ใช้
ขั้นตอนที่ 4 สำคัญที่สุด เพราะเป็นจุดที่เราควบคุมว่าอะไรจะออกจากเครื่องบ้าง
การลดต้นทุน 30 เท่ามาจากไหน
ลองคำนวณจากกรณีจริง:
- สถานการณ์ A: ส่งเอกสาร 100,000 token ขึ้น GPT-4o ให้สรุป ต้นทุนประมาณ $1.50 ต่อครั้ง
- สถานการณ์ B: ใช้ Llama 3 8B รันในเครื่องอ่านเอกสาร 100,000 token ส่งเฉพาะสรุป 2,000 token ขึ้น Cloud ให้วางแผน ต้นทุนประมาณ $0.05 ต่อครั้ง
ผลต่างประมาณ 30 เท่า และยิ่งเอกสารเยอะเท่าไหร่ ยิ่งประหยัดมากขึ้น เพราะต้นทุนหลักของ Cloud คือการประมวลผล input token จำนวนมาก ซึ่ง Local รับภาระนี้แทนหมดแล้ว
ตัวอย่างโค้ด Python
ติดตั้ง Ollama และโมเดล Llama 3 ก่อน:
ollama pull llama3:8b
โค้ดสำหรับสร้าง Secure Minions Pipeline:
import requests
import json
import re

OLLAMA_URL = "http://localhost:11434/api/generate"
CLOUD_API_URL = "https://api.openai.com/v1/chat/completions"
CLOUD_API_KEY = "your-key-here"

def frontier_plan(user_instruction: str) -> list:
    """ให้ Cloud วางแผนงาน โดยไม่ส่งเอกสารดิบ"""
    prompt = f"""คุณคือ AI Planner จงวางแผนงานเป็น JSON array สำหรับคำสั่งนี้:
{user_instruction}

รูปแบบ: [{{"task": "...", "type": "extract|summarize|classify"}}]
"""
    resp = requests.post(CLOUD_API_URL, headers={
        "Authorization": f"Bearer {CLOUD_API_KEY}"
    }, json={
        "model": "gpt-4o",
        "messages": [{"role": "user", "content": prompt}],
        "temperature": 0.2
    })
    return json.loads(resp.json()["choices"][0]["message"]["content"])

def local_execute(task: dict, document: str) -> str:
    """ให้ Local LLM ทำงานกับเอกสารจริง"""
    prompt = f"""ทำงาน: {task['task']}
ประเภท: {task['type']}

เอกสาร:
{document}

ตอบเฉพาะผลลัพธ์ ไม่ต้องอธิบาย
"""
    resp = requests.post(OLLAMA_URL, json={
        "model": "llama3:8b",
        "prompt": prompt,
        "stream": False
    })
    return resp.json()["response"]

def sanitize(text: str) -> str:
    """ลบข้อมูลอ่อนไหวก่อนส่งกลับ Cloud"""
    # ลบเบอร์โทรศัพท์
    text = re.sub(r'\b\d{2}-\d{3}-\d{4}\b', '[REDACTED]', text)
    # ลบอีเมล
    text = re.sub(r'[\w.-]+@[\w.-]+', '[REDACTED]', text)
    # ลบเลขบัตรประชาชน
    text = re.sub(r'\b\d{1}-\d{4}-\d{5}-\d{2}-\d{1}\b', '[REDACTED]', text)
    return text

def run_secure_minions(instruction: str, document: str) -> str:
    plan = frontier_plan(instruction)
    results = []
    for task in plan:
        raw_result = local_execute(task, document)
        safe_result = sanitize(raw_result)
        results.append(safe_result)

    # ส่งสรุปกลับไปให้ Cloud ทำ final synthesis
    final_prompt = "รวบรวมผลลัพธ์ต่อไปนี้เป็นคำตอบสุดท้าย:\n" + "\n".join(results)
    # เรียก Cloud อีกครั้ง...
    return final_prompt
ฟังก์ชัน sanitize คือหัวใจของความปลอดภัย คุณสามารถเพิ่มกฎการลบข้อมูลได้ตามความต้องการขององค์กร
ข้อควรระวังในการใช้งาน
ความเร็วของ Local LLM
โมเดล 8B พอรันบนเครื่องทั่วไปได้ แต่ถ้าเอกสารยาวมาก ความเร็วอาจตก 5-10 token ต่อวินาทีบนเครื่องไม่มี GPU แนะนำให้ใช้เครื่องที่มี GPU อย่างน้อย 8GB VRAM หรือใช้บริการ Cloud GPU ราคาถูก
คุณภาพของ Local Model
Llama 3 8B ทำงานสกัดข้อมูลได้ดี แต่ถ้าเอกสารเป็นภาษาไทยล้วน อาจต้องลองโมเดลอย่าง Qwen 2.5 หรือ Typhoon ที่ฝึกมาเฉพาะภาษาไทย ตรวจสอบผลลัพธ์เสมอก่อนส่งขึ้น Cloud
การรั่วไหลผ่าน Prompt
ถ้า Local ส่งข้อมูลดิบติดมาในผลสรุปโดยไม่ตั้งใจ sanitize อาจพลาดได้ แนะนำให้เพิ่ม Local LLM ตัวที่สองทำหน้าที่ตรวจสอบผลก่อนส่งออก เรียกว่า "Gatekeeper" ในไปป์ไลน์
กรณีศึกษา: บริษัทประกันวัยกลางคน
บริษัทประกันแห่งหนึ่งในไทยมีเอกสารเคลมประมาณ 50,000 ฉบับต่อเดือน ก่อนใช้ Secure Minions พวกเขาจ้างคนอ่านและจัดหมวด ใช้เวลา 3-4 วันต่อเดือน
หลังนำระบบนี้ไปใช้:
- Local LLM อ่านเคลมและสกัดข้อมูลสำคัญ (ชื่อ วันที่ มูลค่า สาเหตุ)
- Cloud Model จัดหมวดเคลมและแนะนำการติดตาม
- ข้อมูลลูกค้าไม่ออกจากเครื่องเซิร์ฟเวอร์ภายใน
- ต้นทุน Cloud ลดจาก 200,000 บาทเหลือ 6,000 บาทต่อเดือน
- เวลาประมวลผลลดจาก 4 วันเหลือ 6 ชั่วโมง
สรุป
Secure Minions ไม่ใช่แค่เทคนิคประหยัดต้นทุน แต่เป็นวิธีทำให้องค์กรไทยใช้ AI ได้โดยไม่ต้องละเว้นความปลอดภัยข้อมูล ความฉลาดของ Frontier Model ผสมกับความปลอดภัยของ Local LLM คือสมการที่ตอบโจทย์ธุรกิจในบริบทที่ข้อมูลคือสินทรัพย์มีค่า
ถ้าคุณกำลังมองหาวิธีนำ AI เข้าองค์กรโดยไม่เสี่ยงข้อมูลรั่ว ลองเริ่มจากไปป์ไลน์ง่ายๆ ในบทความนี้ก่อน แล้วค่อยขยายผล อย่าลืมแชร์ประสบการณ์หรือคำถามในคอมเมนต์ หรือถ้ามี use case ในองค์กรของคุณ บอกเรามาได้เลย เราอยากรู้ว่าคุณจะประยุกต์ใช้ Secure Minions กับงานอะไร
เนื้อหาที่จัดทำโดยมี AI ช่วยจะมีป้ายกำกับ "เรียบเรียงโดยมี AI ช่วย" เพื่อให้คุณทราบอย่างชัดเจน เราถือว่าความโปร่งใสเรื่องการใช้ AI เป็นสิ่งสำคัญต่อความไว้วางใจของผู้อ่าน
ความคิดเห็น (0)
ยังไม่มีความคิดเห็น — มาเป็นคนแรกกันเถอะ!